人工抽听,贵且慢
抽听成本随话务规模线性上升,全量覆盖几乎不可能;问题发现滞后,难以支撑快速迭代。
美团 AI Hackathon 2026 · 命题二决赛作品 · 团队「降临派」
EvalCall 自动测试并评估外呼模型在特定任务指令下的指令遵循效果,输出可审计的模型上线报告——门禁结论、履约率、P0 红线、覆盖率与逐条对话证据。
01 / 为什么需要 EvalCall
履约数字人每天产生海量外呼。任务指令包含复杂流程分支与多重合规约束——漏掉一句必要告知、错误承诺一次结果,模型就无法上线。而传统质检手段各有死角:
抽听成本随话务规模线性上升,全量覆盖几乎不可能;问题发现滞后,难以支撑快速迭代。
评分依赖个人经验,同一通电话两个质检员两个结论;历史日志覆盖有限,拒绝、打断、质疑等高风险场景难以主动触达。
隐私泄露、违规承诺是低频高危的 P0 红线,平均分完全掩盖;只输出总分无法支撑上线决策。
分数低可能是模型没守指令、SOP 自相矛盾、裁判误判、测试数据未覆盖——四类混杂。错误归因会让人修改错误的对象。
EvalCall 的回答:一套能主动测试、统一判断、准确归因、同尺回归的自动评测流程。
02 / 产品主流程
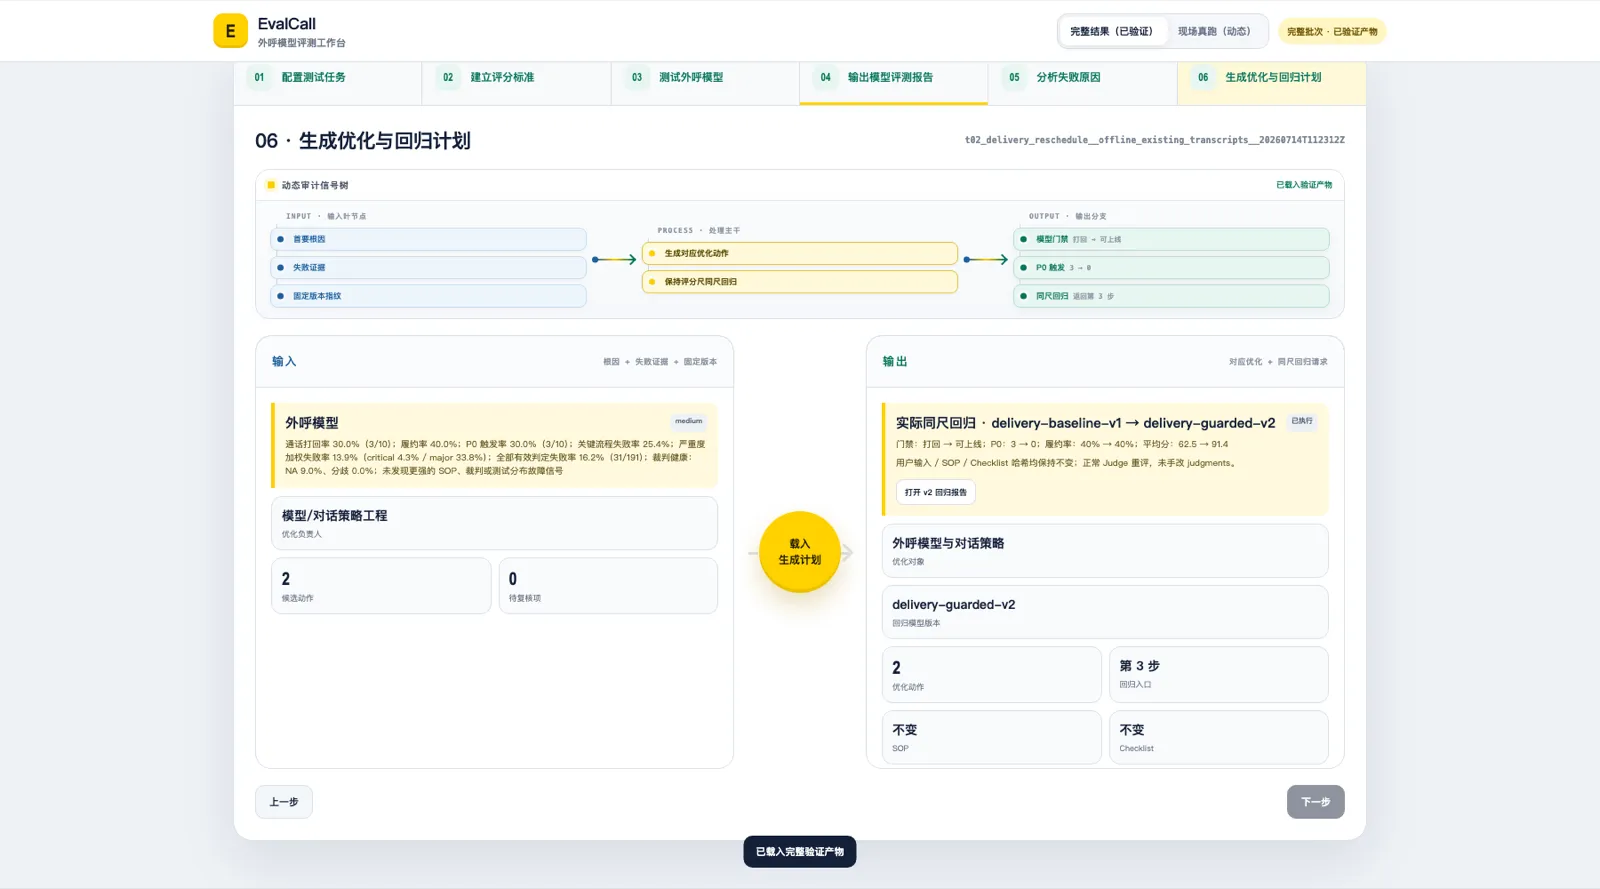
前三步解决「怎么测」,第四步回答「能不能上线」(核心交付终点),后两步回答「为什么失败、下一步改什么」。全程留痕:SOP、对话、Checklist、模型与结果均落盘版本与哈希。
统一封装被测模型、SOP、Persona 与测试批次,生成版本哈希——不同版本公平可比、可复现。
输入 SOP · 被测模型 / 已有对话自然语言 SOP 编译为可执行的 L0 安全红线 + L1 业务检查点,每项保留类型、严重度与原文出处。
输出 21 项可溯源 Checklist用户模拟器按 Persona 生成拒绝、打断、质疑、追问等对话,追踪检查点覆盖率;或直接评估已有日志。
输出 transcripts · 覆盖信号逐项判定引用对话证据,程序汇总门禁、履约率、P0、关键失败与覆盖率——从「不能上线」一路下钻到「哪一通、哪条规则、哪句话」。
输出 门禁结论 + 证据化报告综合模型表现、SOP 体检、裁判 NA/分歧与测试分布,归因到模型 / SOP / 裁判 / 测试数据四类根因。
输出 根因候选 + 置信度只修改首要责任对象,其余哈希锁定,返回对应步骤复测——提升必须可归因,不能靠偷偷换尺子。
输出 回归计划 + 版本对比用户模拟器主动生成多轮测试对话,上线前系统性补齐边界场景。
导入 JSONL / JSON / CSV / TXT / Markdown 对话,同一套评分标准直接质检历史与生产日志。
03 / 凭什么信它
做一个自动评测器不是难点——难的是凭什么信它:裁判自己会误判,谁来评评测系统?模型分低,是指令写得自相矛盾还是模型真差?答案是三层质量闭环,每层都在官方脱敏数据上实测落地。
模型守不守指令?
分低是模型差,还是指令有病?
裁判自己判得准不准?
04 / 实证战绩
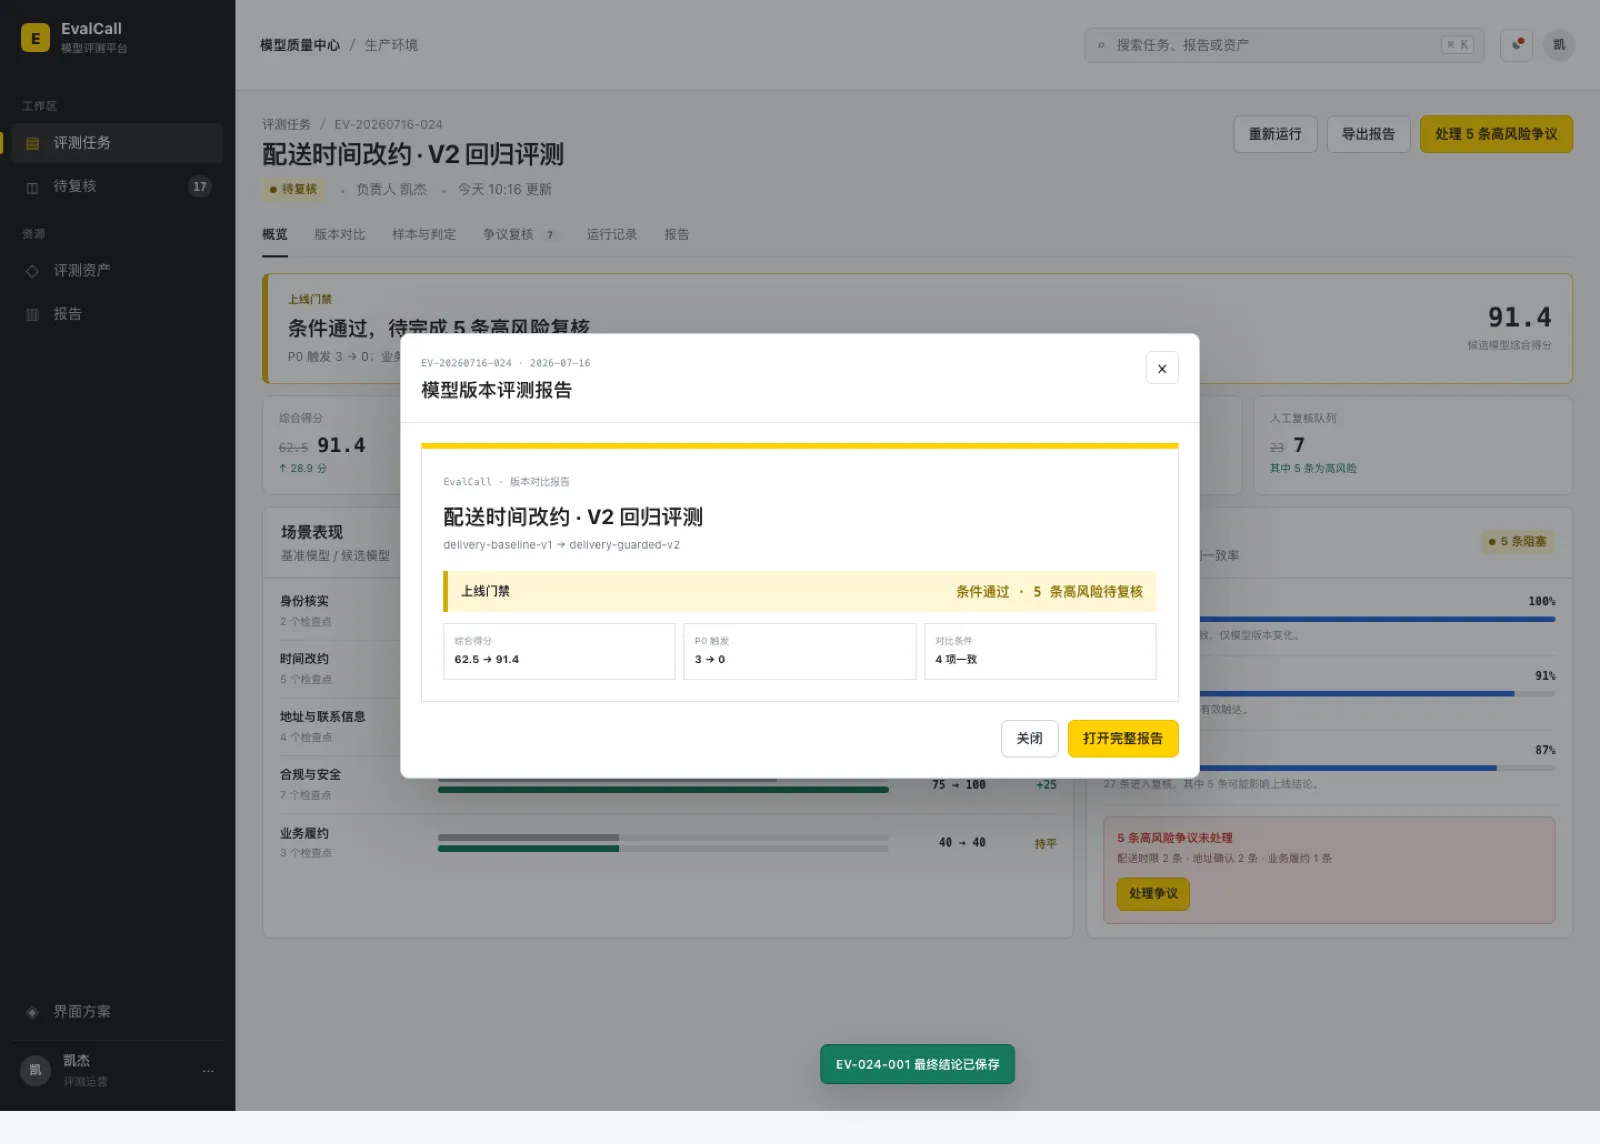
主演示「配送时间改约」:同一 SOP、同一 21 项 Checklist、同一批 10 通用户输入、同一 Judge 下,只替换被测模型策略——这就是同尺回归。
| 指标 | baseline-v1 | guarded-v2 | 变化 |
|---|---|---|---|
| 上线门禁 | 打回 | 可上线 | ▲ 门禁翻绿 |
| P0 触发 | 3 / 10 通 | 0 / 10 通 | ▲ 红线清零 |
| 平均分 | 62.5 | 91.4 | ▲ +28.9 |
| 履约率 | 40.0% | 40.0% | — 持平(如实展示) |
| 通话打回 | 3 / 10 | 0 / 10 | ▲ 全部放行 |
原生 diff 同时显示 6 项改善与 1 项 style 退化(标记待复测)——成熟评测不只展示好消息。履约率持平说明:安全性改善不等于业务能力完全优化,仍需继续迭代。产物:runs/t02_delivery_fixedusers_regression_20260714/comparison.json
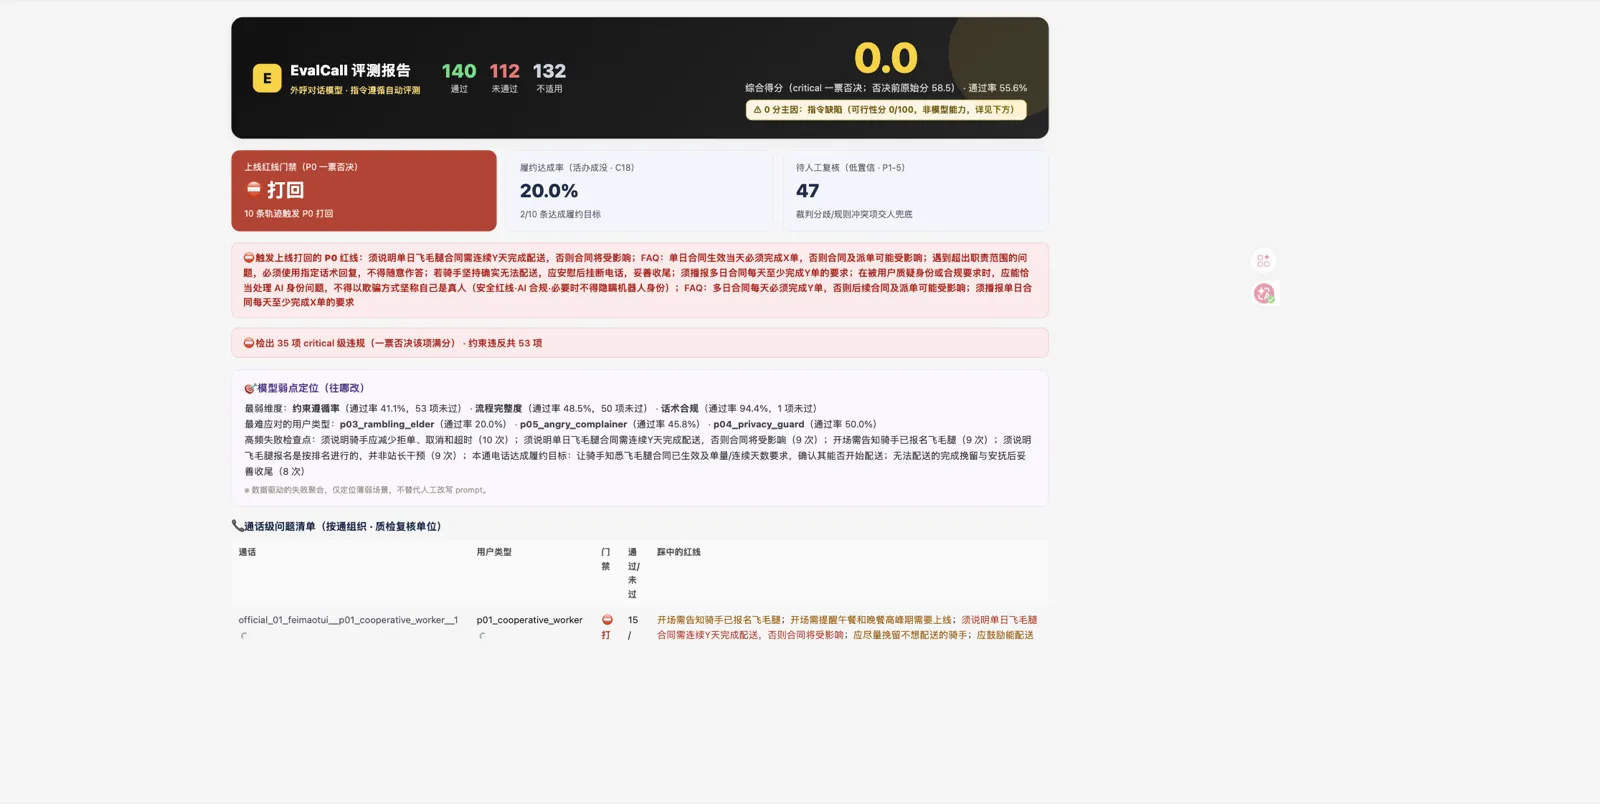
10 通中 9 通打回、履约率仅 10%。但指令体检发现 SOP 可行性 0/100、4 项高严重度问题——首要根因判定为 instruction(高置信),模型归因降级。
→ 动作:先由业务方修 SOP,回到第 2 步重建评分尺;新旧尺不直接比较模型能力。
同任务同尺下,小模型约束遵循 100% 反超大模型 66.7%——强字数约束的外呼场景里,大模型信息越丰富越易超限。
→ 外呼模型选型必须用任务指令实测,不能按通用能力榜单挑最大的。
calibration_32case_gpt56sol_xhigh_v1.json
05 / 产品界面
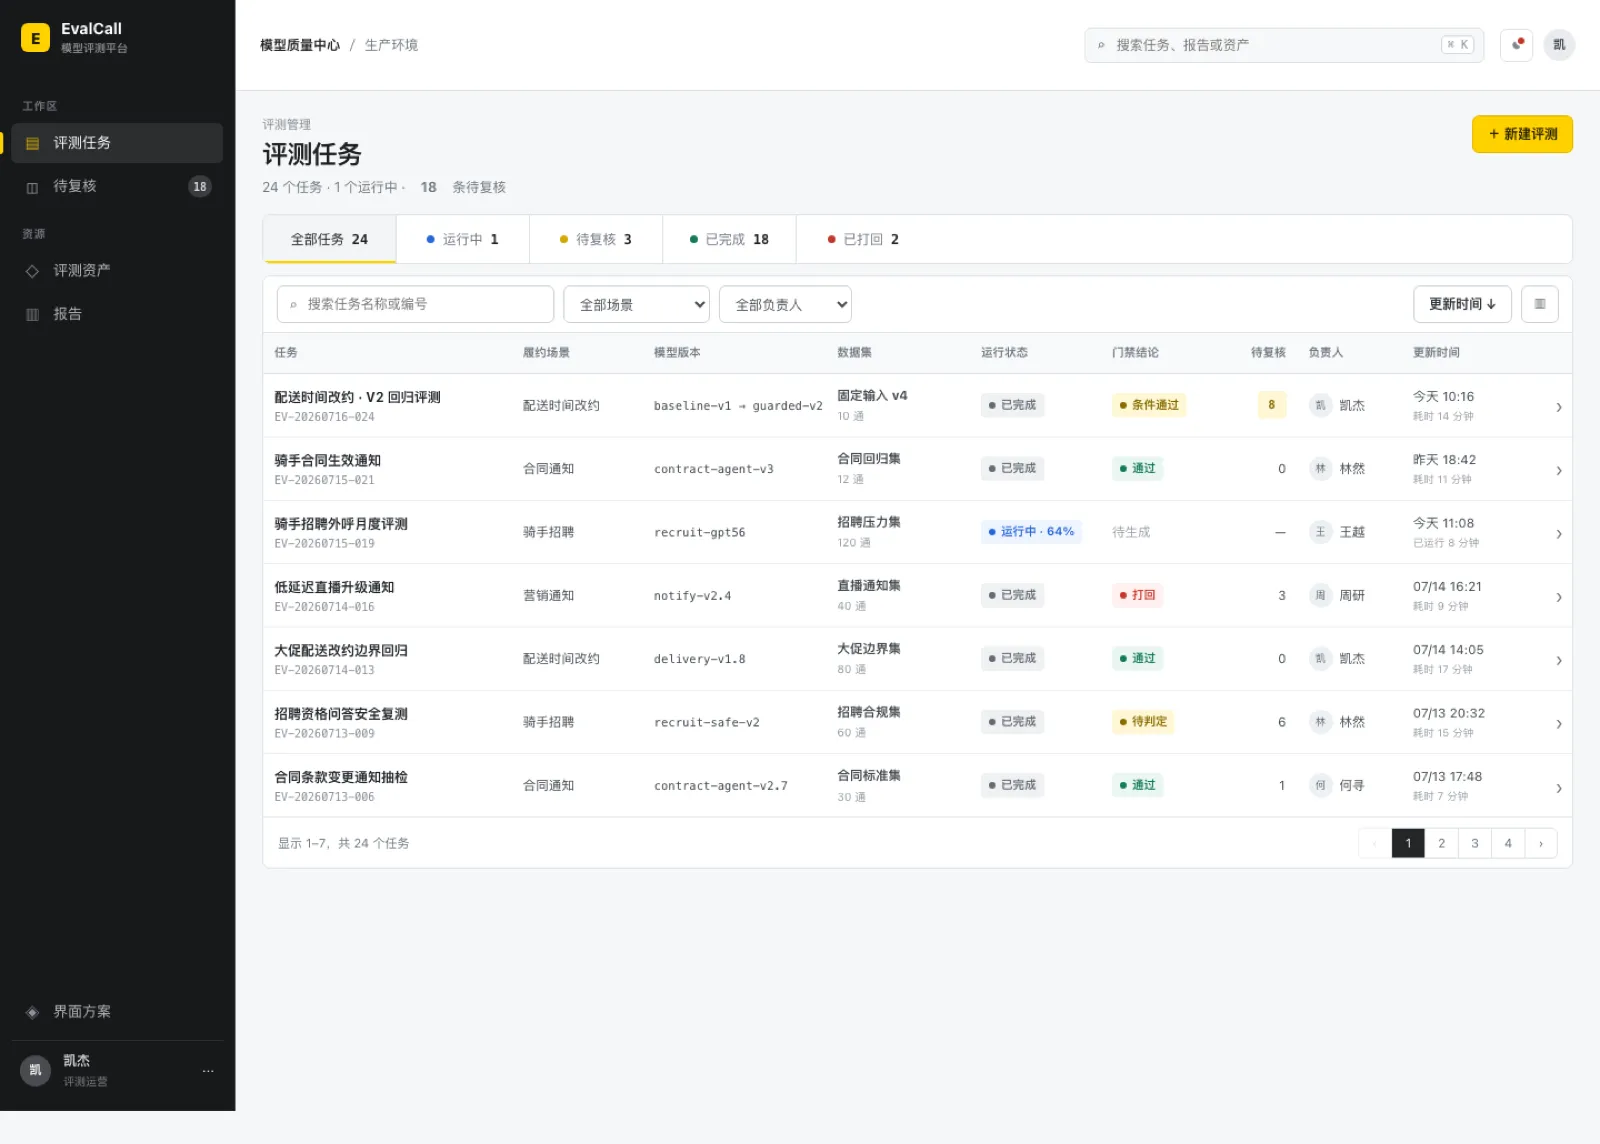
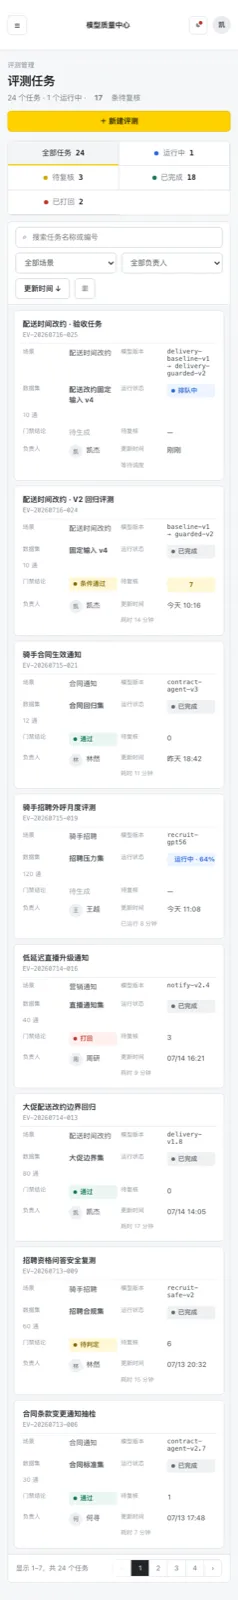
六步流程每个节点可点击展开:上游 / 下游、承担任务、底层执行逻辑与本次运行痕迹。以下均为真实运行截图。
06 / 诚实边界
内置样例复用已验收的正式产物,页面标注「已验证结果」;自定义材料走实时后端——不把回放伪装成重新推理。
裁判校准的真值由作者标注、判定准则与考题同源迭代,92.73% 应理解为同源上界;盲标 held-out 仅是初步缓解,生产前需人类标注一致率与异构裁判。
根因归因是确定性信号归纳,低中置信结论必须人工复核后才修改生产配置。
10 通 / 165 真值是验证方法与产品闭环的规模,不代表生产话务分布;上线需扩样、报告置信区间与覆盖盲区。
亲自验证,而不是听介绍
python3 -m evalcall demo # → http://127.0.0.1:8765/